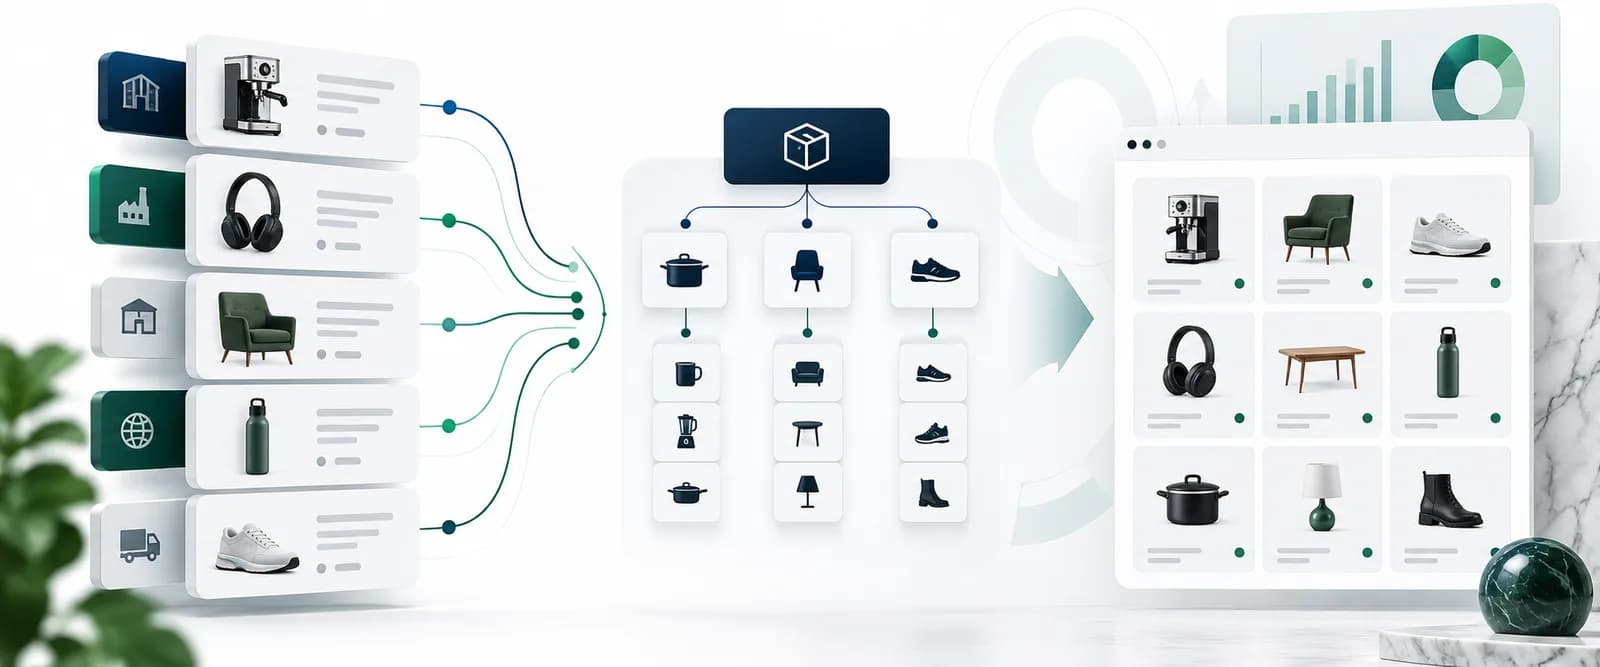
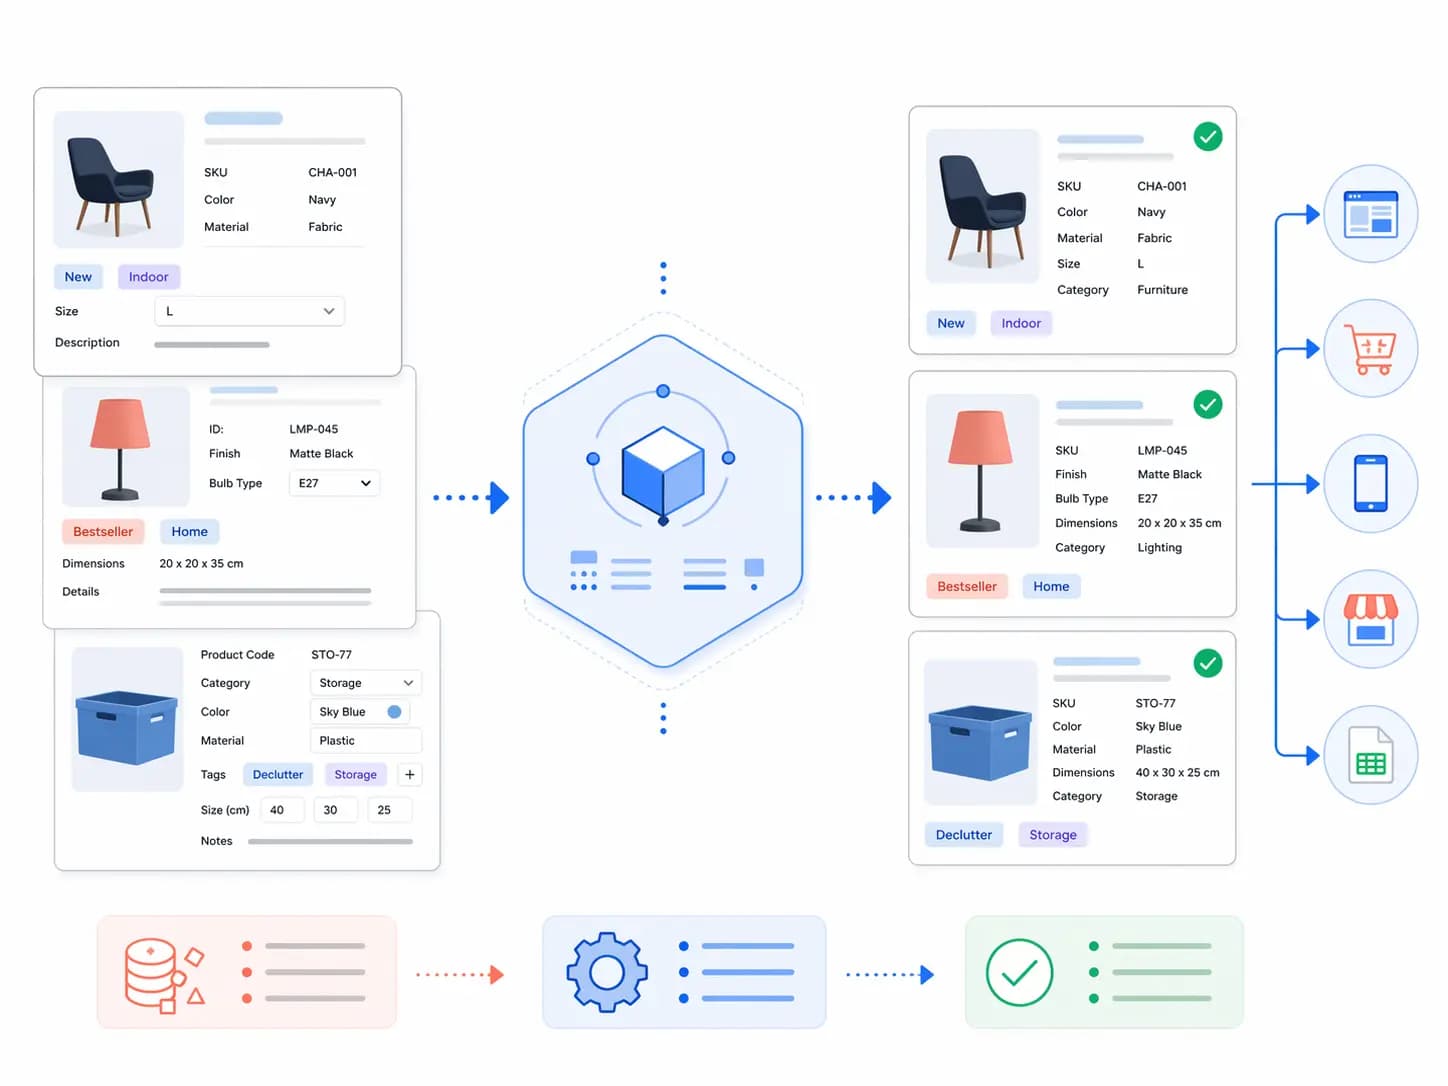
Bijna elk groeiend productteam begint in een spreadsheet. Meestal Excel, soms Google Sheets. En in het begin is die keuze volkomen redelijk. U heeft een overzichtelijke catalogus, een klein team, misschien één verkoopkanaal, en de spreadsheet voelt snel, flexibel en vertrouwd.
Dan groeit de catalogus. Meer mensen werken eraan. Er komen kanalen bij. Meer leveranciers sturen bestanden in hun eigen formaat. Varianten vermenigvuldigen zich. Lanceringen worden trager. En op een dag beseft u dat de spreadsheet u niet meer helpt de productdata te beheersen: uw team moet er omheen werken.
Dat is het echte gesprek over PIM of spreadsheets. Niet de dramatische versie van leveranciers, maar de praktische.
Bent u nieuw met PIM als categorie, begin dan met Wat is PIM? De gids voor 2026 voor e-commercemerken en retailers of de eenvoudigere hub PIM-basis .
- Spreadsheets zijn prima voor kleine, eenvoudige catalogi met weinig medewerkers en één hoofdkanaal.
- Ze haken af zodra varianten, goedkeuringen, attribuutconsistentie en multichannelpublicatie ertoe doen.
- De grootste kostenpost van een spreadsheet is niet het bestand zelf, maar het herhaalde handwerk, de verborgen fouten en het gebrek aan operationele controle.
- Een PIM “slaat” productdata niet alleen “op”. Het geeft structuur, validatie, workflow, eigenaarschap en gecontroleerde uitvoer.
- U heeft op dag één geen PIM nodig. Maar zodra uw spreadsheet elke week wrijving veroorzaakt, bent u meestal al laat in de beslisperiode.
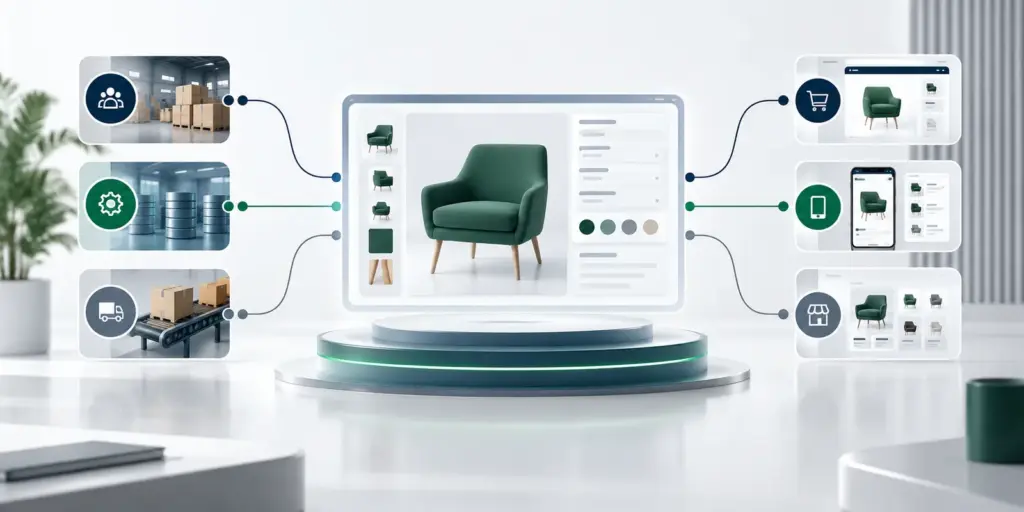
PIM-workflow die leveranciersproductdata verbindt met webshops en verkoopkanalen
Waarom spreadsheets in het begin goed voelen
Omdat ze gemakkelijk zijn om mee te beginnen.
U maakt snel kolommen aan. Iedereen in het team kent de basisinterface al. U heeft geen implementatieplanning nodig om producten op een lijst te krijgen. Voor een catalogus in de beginfase is een spreadsheet vaak de kortste weg van “dit moeten we ordenen” naar “we hebben iets bruikbaars”.
Juist daarom blijven zoveel teams er langer bij dan verstandig is. Het gemak in het begin verbergt de operationele kosten op de lange termijn.
Zelfs Google Sheets ondersteunt keuzelijsten en gegevensvalidatie, wat teams een tijd lang zeker helpt consistenter te werken. Maar die controles blijven licht vergeleken met regels op categorieniveau, goedkeuringsstatussen, overervingslogica, auditeerbaarheid en beheerste kanaaluitvoer. De eigen documentatie van Google laat zien hoe basale keuzelijsten en validatiecontroles werken : nuttig, maar beperkt voor catalogusoperaties op schaal.
Wanneer een spreadsheet geen hulpmiddel meer is maar infrastructuur
Dit is de verschuiving die de meeste teams missen.
Een spreadsheet is prima zolang het een werkbestand is. Het wordt riskant wanneer het ongemerkt het systeem achter uw catalogus wordt. Dat gebeurt meestal als het bestand al deze taken tegelijk vervult:
- hoofdlijst van producten
- opslag van attributen
- importbestand voor leveranciers
- lanceringstracker
- basis voor kanaalexports
- vervanging van een goedkeuringsworkflow
- checklist voor datakwaliteit
Zodra één bestand dit alles probeert te zijn, gebruikt u geen spreadsheet meer voor het gemak. U bent ervan afhankelijk als operationele infrastructuur.
8 signalen dat uw productcatalogus zijn spreadsheet is ontgroeid
1. U heeft meer dan één “hoofdbestand”
Hier wordt het probleem meestal het eerst zichtbaar. Eén bestand is “de nieuwste versie”. Een ander is de versie voor Amazon. Weer een ander is “het schone bestand”. Iemand heeft een lokale back-up “voor de zekerheid”.
Moet uw team vragen welk bestand actueel is, dan heeft u geen betrouwbaar werkmodel meer. U heeft onderhandelingen.
Daarom is één bron van waarheid zo belangrijk in productoperaties.
2. Eén productupdate betekent hetzelfde feit op meerdere plekken corrigeren
Er komt een maatcorrectie van de leverancier. Eenvoudig genoeg. Dan past iemand de spreadsheet aan. Daarna Shopify. Dan het marktplaatsbestand. Dan een pdf-blad. Misschien nog een feedexport.
Het probleem is niet alleen tijd. Herhaald handwerk schept herhaalde kansen op afwijkingen.
3. Variantbeheer wordt een rommelige verzameling platte rijen
Bij varianten voelen spreadsheets bijzonder onnatuurlijk. Een productfamilie met 5 kleuren en 6 maten wordt 30 rijen. Voeg aparte barcodes, variantafbeeldingen, verpakkingsgroottes of gelokaliseerde teksten toe en de structuur wordt razendsnel kwetsbaar.
Platte rijen zijn niet onmogelijk. Ze zijn alleen het verkeerde model voor ouder-kindrelaties tussen producten.
Voor de structurele kant hiervan gaat u verder naar productdatamodellering voor PIM .
4. Niets belet iemand om iets te bewerken
Hier gaan teams vertrouwen op ongeschreven regels.
“Wijzig de groene kolommen niet.” “Vraag eerst voordat je dat tabblad bewerkt.” “Alleen marketing mag dat veld aanraken.” Het klinkt onschuldig, maar het zijn geen echte controles. Het zijn sociale afspraken die het werk van systeemlogica proberen te doen.
Zodra meer dan een paar mensen erbij betrokken zijn, is dat een governanceprobleem en niet alleen een spreadsheetprobleem.
5. Uw attribuutwaarden zitten vol bijna-duplicaten
Dit is een van de meest voorkomende problemen met cataloguskwaliteit: Katoen, katoen, 100% katoen, puur katoen, katoenen stof. Technisch verschillende waarden. Operationeel hetzelfde. En die kleine inconsistentie veroorzaakt grotere problemen verderop, in filters, feeds, exports en rapportages.
Beheerste waarden zijn een van de eerste plekken waar de flexibiliteit van een spreadsheet ophoudt een voordeel te zijn en een kwaliteitsrisico wordt.
6. Opschonen vóór een lancering is een terugkerend ritueel geworden
Hangt elke lancering ervan af dat iemand handmatig ontbrekende afbeeldingen, onvolledige attributen en opmaakproblemen controleert voordat producten live gaan, dan is dat geen gezonde workflow. Het is een noodgreep voor ontbrekende validatie.
Op dat punt doet het team kwaliteitscontrole op geheugen en paniek in plaats van via systeemontwerp.
7. Nieuwe teamleden hebben te lang nodig om ingewerkt te raken
Zit de logica van de catalogus in koppen van mensen in plaats van in het systeem, dan wordt inwerken traag en riskant. Nieuwe mensen hebben de “echte uitleg” nodig achter tabbladen, kleuren, uitzonderingen, formules en naamgevingsconventies. En elke keer dat iemand vertrekt, gaat een deel van die operationele kennis mee.
8. Uw catalogus groeit, maar lanceringen worden trager
Dit is vaak het duidelijkste signaal. Groei zou uw processen gedisciplineerder moeten maken, niet chaotischer. Is de catalogus groter, maar kost elke lancering meer tijd dan vorig jaar, dan ligt het probleem meestal niet alleen aan inspanning. De onderliggende workflow schaalt gewoon niet meer netjes mee.
De verborgen kosten van catalogusbeheer in spreadsheets
De meeste teams berekenen deze kosten niet, omdat ze niet als één regel op de begroting staan. Ze verschijnen in brokstukken.
- herhaald kopieer-en-plakwerk over kanalen heen
- trage lanceringen door handmatige review
- fouten in listings die live kanalen bereiken
- kapotte filters of inconsistente facetten
- teamtijd die verloren gaat aan uitzoeken welke versie klopt
- leveranciersupdates die moeten worden opgeschoond voordat ze bruikbaar zijn
- SEO- en feedvelden die uit de pas lopen omdat niemand ze duidelijk beheert
Dit is de “spreadsheetbelasting”. Ze is echt, ook als ze in één enkele week niet dramatisch lijkt.
Wat een PIM in de praktijk verandert
Het grootste verschil is niet dat een PIM uw productdata in een mooiere interface bewaart. Het echte verschil is dat het de catalogus regels geeft.
- één beheerst productrecord in plaats van meerdere concurrerende bestanden
- gestructureerde attributen in plaats van vrije invoer
- variantrelaties die logisch zijn
- controle op verplichte velden vóór publicatie
- goedkeuringsstappen in plaats van onbedoelde live-bewerkingen
- kanaalspecifieke uitvoer uit één onderhouden record
- inzicht in wijzigingen en auditeerbaarheid
Vergelijkt u categorieën, dan helpt het ook om PIM, MDM, DAM en PXM te begrijpen. De meeste teams die in spreadsheets vastzitten, hebben niet eerst ruimer enterprise-MDM nodig. Ze hebben eerst betere productdataoperaties nodig.
Spreadsheet versus PIM op operationeel niveau
| Mogelijkheid | Spreadsheet | PIM |
|---|---|---|
| Eén bron van waarheid | In theorie mogelijk, in de praktijk kwetsbaar | Ontworpen voor beheerste productwaarheid |
| Beheerste attribuutwaarden | Alleen lichte validatie | Gestructureerde waarden en sterkere afdwinging van regels |
| Variantrelaties | Meestal platte rijen | Ouder-kindmodel met duidelijkere overerving |
| Goedkeuringsworkflow | Vooral handmatig en sociaal | Ingebouwd in het operationele proces |
| Volledigheidscontroles | Handmatige review of formules | Validatie die categorie en kanaal kent |
| Kanaaluitvoer | Vaak aparte bestanden per bestemming | Eén onderhouden record, meerdere beheerste uitvoeren |
| Auditeerbaarheid | Beperkt | Betere wijzigingsregistratie en verantwoording |
| Meegroeien met de catalogus | Wordt zwaarder en kwetsbaarder | Beter geschikt voor gestructureerde schaal |
De eerlijke reden om bij spreadsheets te blijven
Niet elk team moet meteen overstappen.
Heeft u een kleine catalogus, één hoofdkanaal, zeer weinig varianten en een of twee mensen die productdata beheren, dan kan een spreadsheet nog steeds het juiste hulpmiddel zijn. Er is geen prijs te winnen met extra software voordat de behoefte echt is.
In dat geval is het slimmer om uw spreadsheet nu nog schoner te maken:
- standaardiseer de naamgeving van kolommen
- gebruik waar mogelijk keuzelijsten
- leg beheerste waarden vast op een referentieblad
- scheid productfamilies zo duidelijk mogelijk van data op variantniveau
- documenteer de verplichte velden per categorie
- bepaal wie welke velden beheert
Die gewoonten helpen u later nog, ook als u uiteindelijk naar een PIM overstapt.
Van spreadsheetchaos naar een schonere overgang naar een PIM
De beste migraties beginnen niet met softwareschermen. Ze beginnen met structuur.
- Bepaal wat het hoofdproductrecord moet bevatten.
- Maak de taxonomie en de categorienamen schoon.
- Definieer kernattributen en verplichte velden.
- Scheid de data op ouderniveau en variantniveau logisch.
- Standaardiseer identificatiecodes zoals SKU, GTIN, MPN en leveranciersreferenties waar van toepassing.
- Bepaal welke velden per kanaal verschillen.
- Leg vast wie verrijking, goedkeuring en publicatie beheert.
Voor identificatiecodes helpt het specifiek om aan te sluiten bij officiële richtlijnen. GS1 definieert de GTIN als de wereldwijde identificatiecode voor handelsartikelen en Google Merchant Center legt uit hoe codes als GTIN, MPN en merk kanalen helpen producten juist te begrijpen. Bekijk het GTIN-overzicht van GS1 en de richtlijnen van Google Merchant Center voor unieke productidentificatiecodes .
Voor de structurele kant is dit de beste vervolgpagina: productdatamodellering voor PIM .
Waar LynkPIM past
LynkPIM is voor het team dat de grens al is gepasseerd waarachter spreadsheets niet meer “simpel” zijn. Het geeft u een plek om productrecords te centraliseren, attributen te beheren, categorieën en varianten goed te modelleren, consistentie af te dwingen en met meer controle naar kanalen te publiceren.
Het doel is niet om uw workflow zwaarder te laten aanvoelen. Het doel is het herhaalde handwerk en de verborgen kwetsbaarheid weg te nemen die spreadsheets veroorzaken zodra uw operatie complexer wordt.
Is uw pijn technischer of specifiek voor B2B, lees dan PIM voor B2B-e-commerce . Is uw pijn fundamenteler, ga dan naar de PIM-woordenlijst of PIM-basis .
Als praktische vervolgstap kunt u ook de PIM-readiness-assessment en de catalogus-gezondheidsscore doen. Voor de bredere structuur, zie onze gids voor producttaxonomie en categoriemapping in e-commerce .
Slotconclusie
Spreadsheets zijn niet de vijand. Ze zijn alleen gemakkelijk te ontgroeien zonder het te merken.
De juiste vraag is niet “Zijn spreadsheets slecht?” De betere vraag is “Vragen we nu van een spreadsheet het werk van een beheerst productdatasysteem?”
Is het antwoord ja, dan gaat het niet meer om voorkeur maar om operationeel risico. En dat is meestal het punt waarop een PIM ophoudt een luxe te zijn en de schonere manier wordt om de catalogus te beheren.
Veelgestelde vragen
Kan ik niet gewoon Google Sheets met add-ons blijven gebruiken?
U kunt een spreadsheet verder uitbreiden dan de meeste teams verwachten. Maar add-ons lossen de diepere problemen rond beheerste workflows, variantstructuur, gecontroleerde publicatie en categoriebewuste volledigheid meestal niet op.
Wat is het echte verschil tussen een spreadsheet en een PIM?
Een spreadsheet is een flexibel bestand. Een PIM is een besturingssysteem voor productinformatie. Het verschil zit niet in de opslag, maar in controle, structuur en herhaalbaarheid.
Bij hoeveel SKU’s moet ik een PIM overwegen?
Er is geen perfect aantal. Complexiteit telt zwaarder dan aantallen. Een paar honderd SKU’s met varianten, meerdere kanalen en meerdere medewerkers kunnen een PIM eerder rechtvaardigen dan een grotere maar eenvoudigere catalogus.
Maakt een PIM het team minder flexibel?
Het haalt meestal de verkeerde soort flexibiliteit weg. U verliest ongecontroleerd bewerken en inconsistente veldinvoer, maar wint een schonere structuur, snellere publicatie en minder herhaalde fouten.
Wat moet ik doen voordat ik van spreadsheets migreer?
Maak de taxonomie schoon, definieer attributen, standaardiseer identificatiecodes, scheid de logica van ouder en variant en leg het eigenaarschap van velden vast. Die stappen maken de implementatie een stuk soepeler.
Volgende stappen: LynkPIM-prijzen bekijken of een LynkPIM-demo aanvragen.
Laatst bijgewerkt: oktober 2026